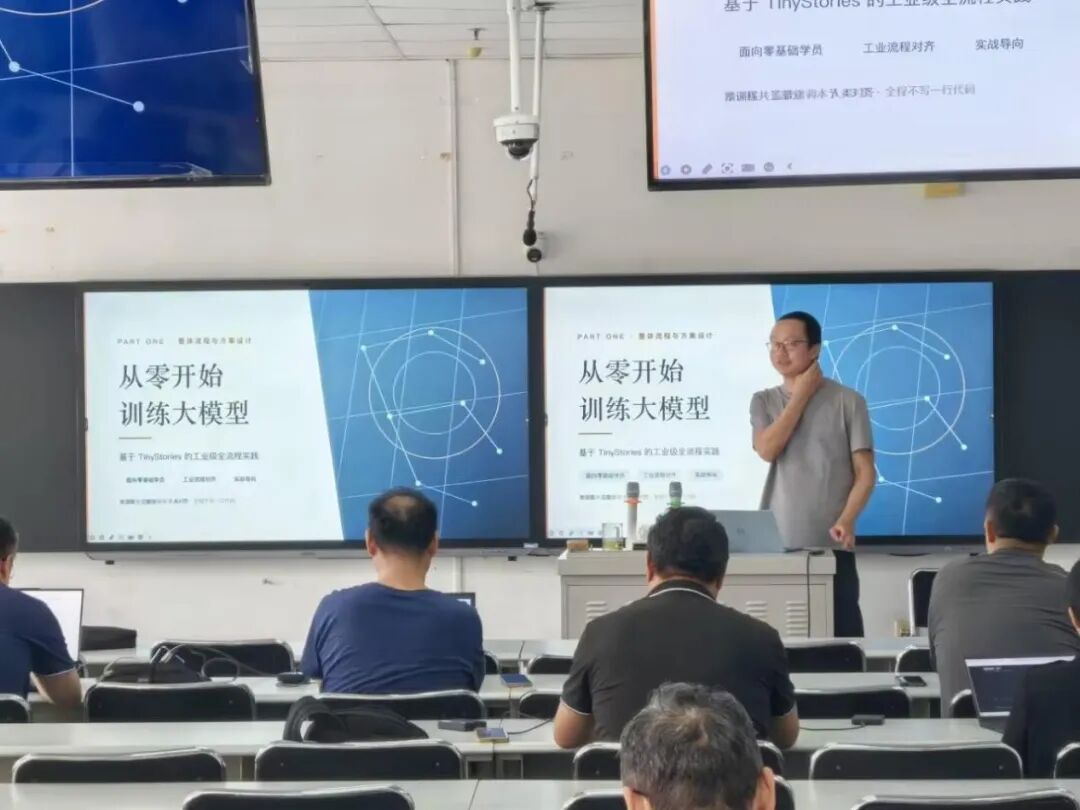
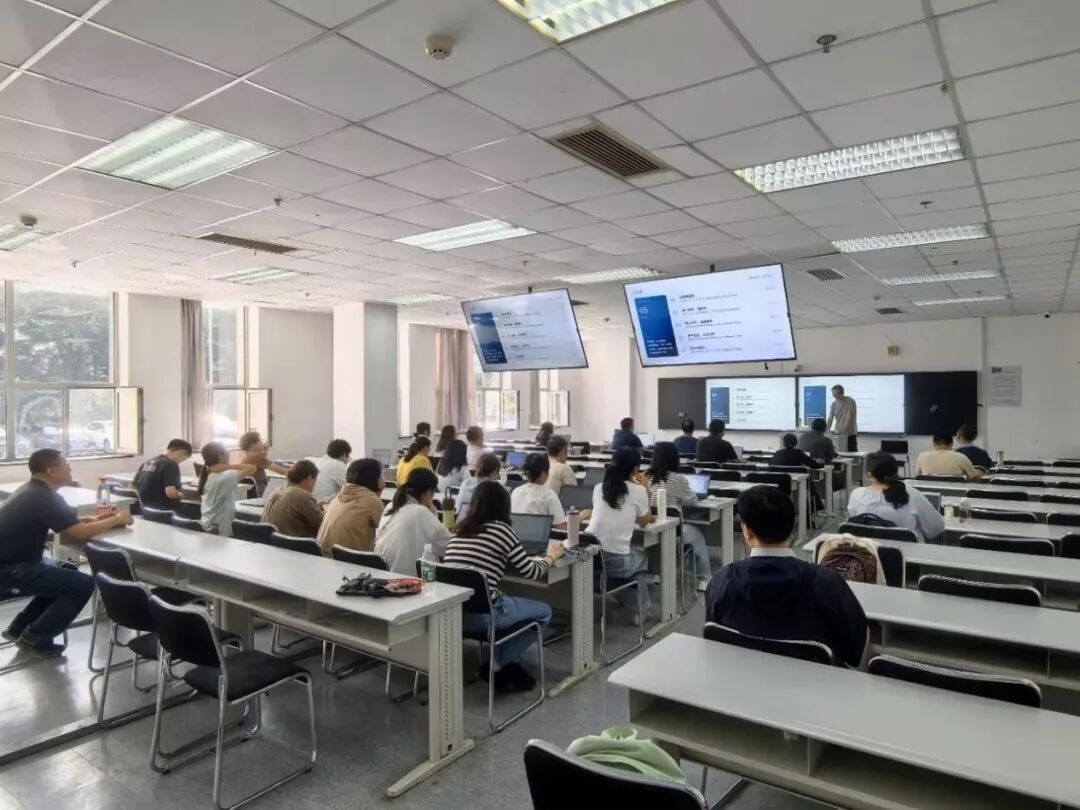
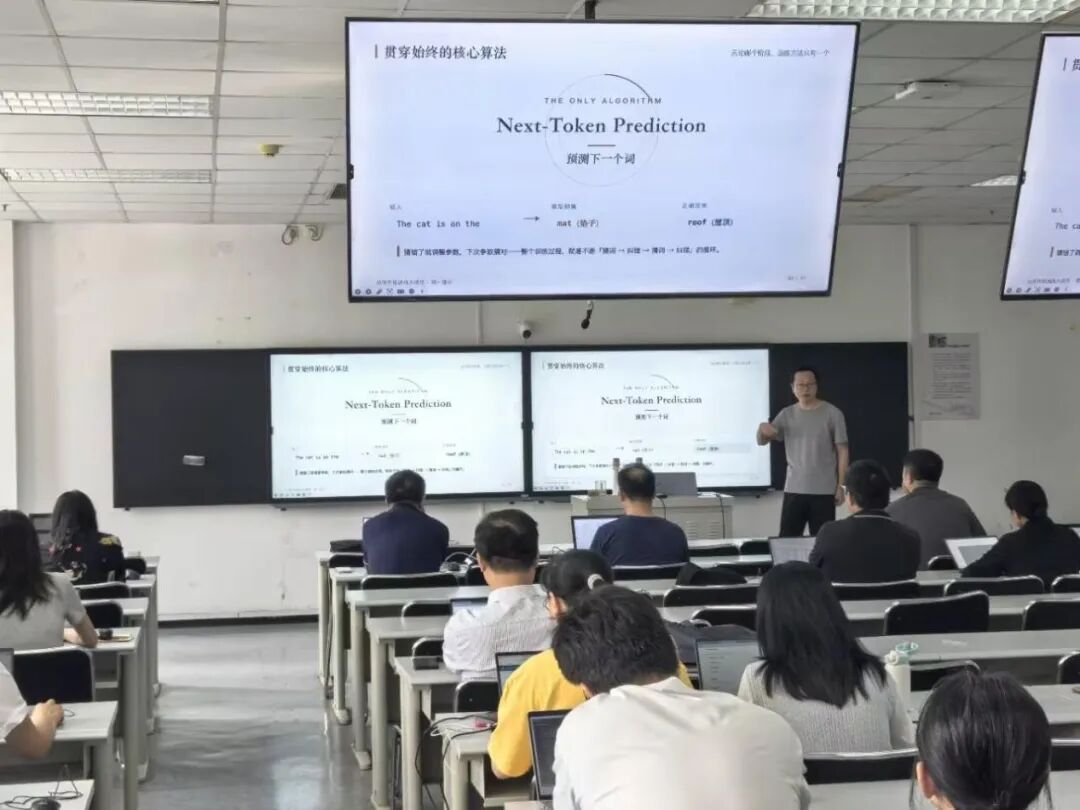
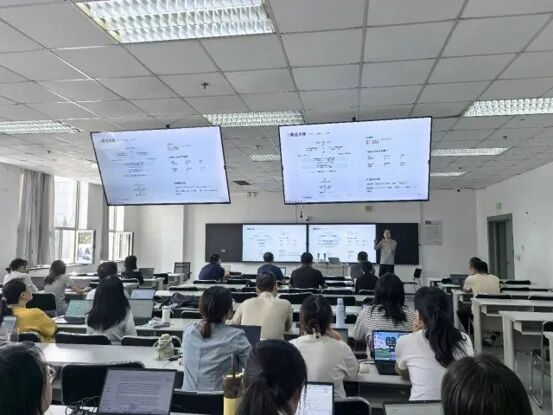
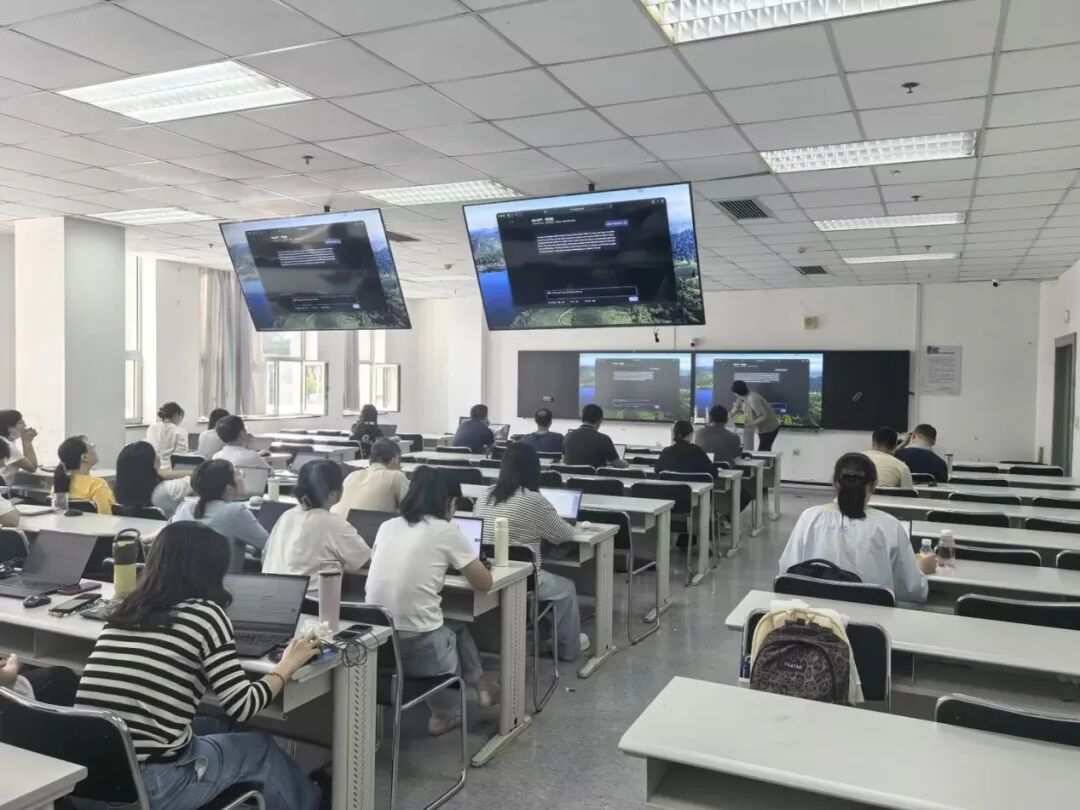
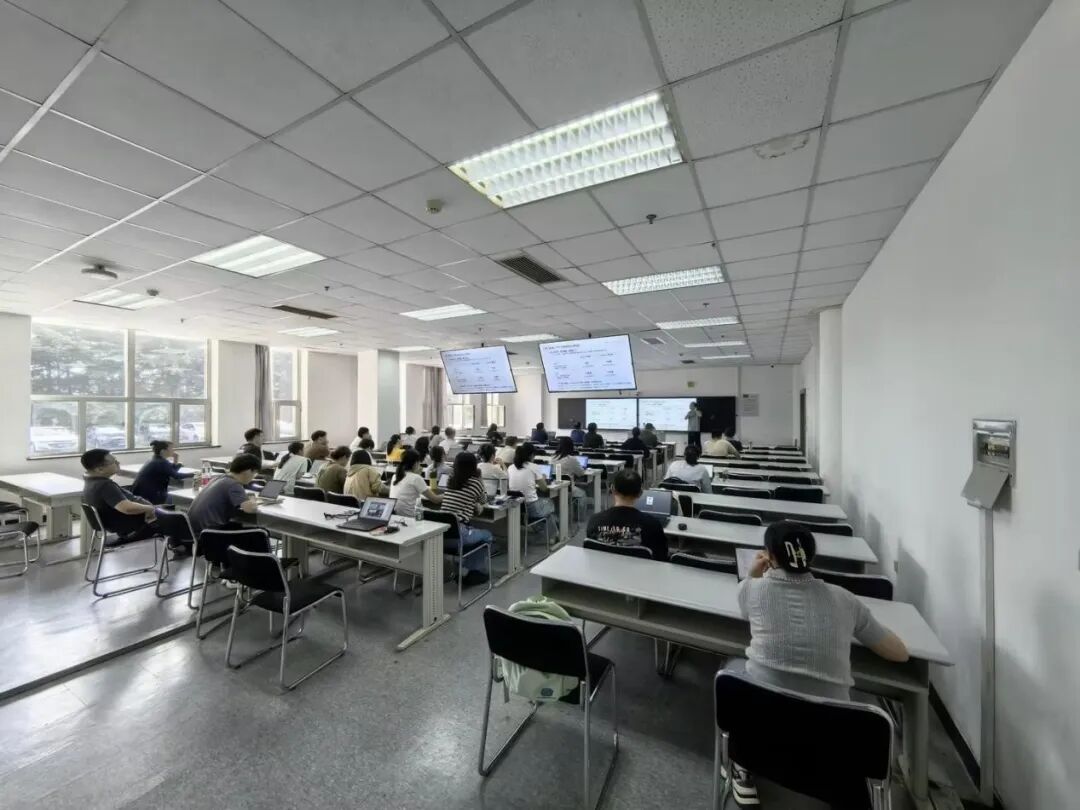
当大模型技术以惊人的速度重塑各行各业,高校教师如何将前沿技术从“理论黑板”搬进“实践课堂”?为提升教师在大模型领域的工程实践教学能力,软件学院于9月29日在软件园校区A3座115室组织开展了“轻微大模型搭建流程培训”专项师资培训活动。本次培训旨在打破“调包”局限,通过从零手写、实测验证的方式,让老师们亲身体验大模型从训练到高并发部署的全链路,为后续的教学改革蓄能。
一、拒绝黑盒:在训练中见证“大脑”生长
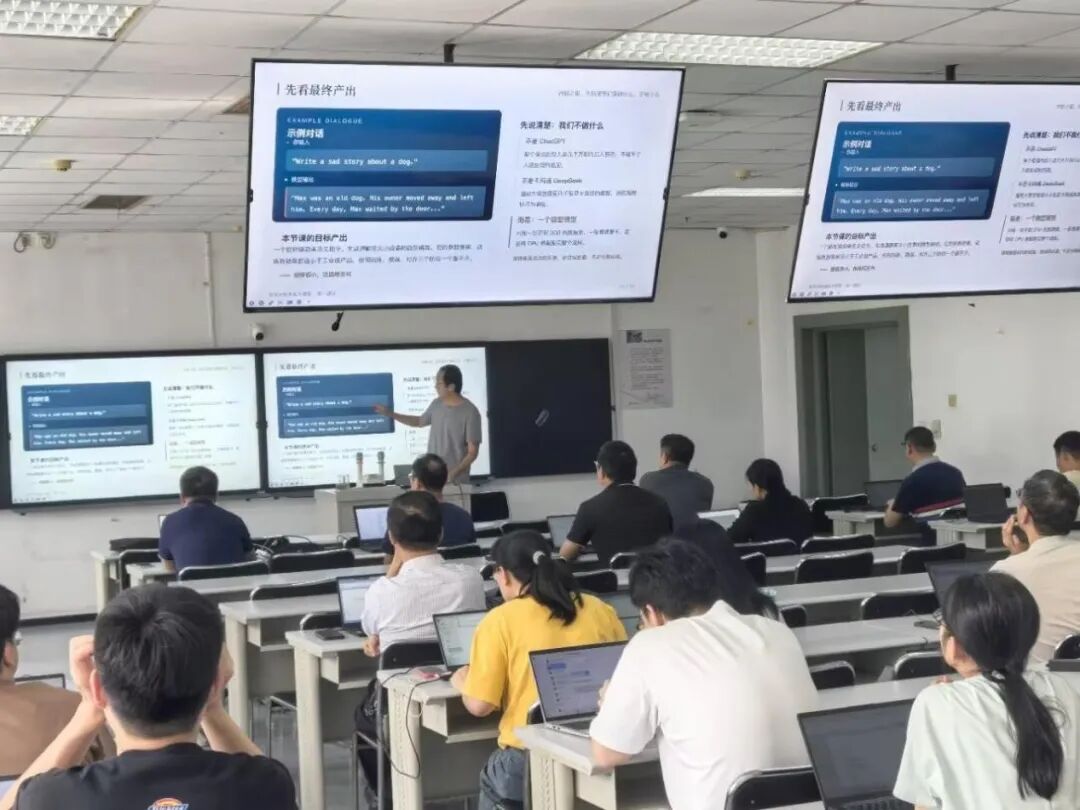
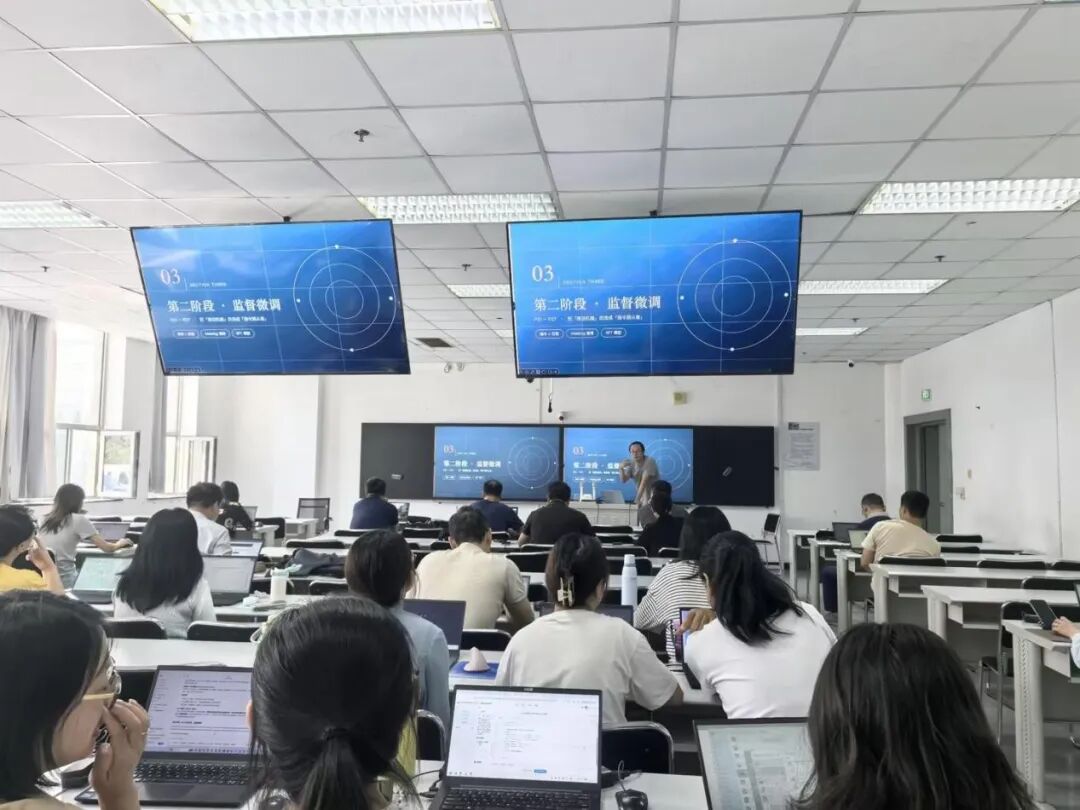
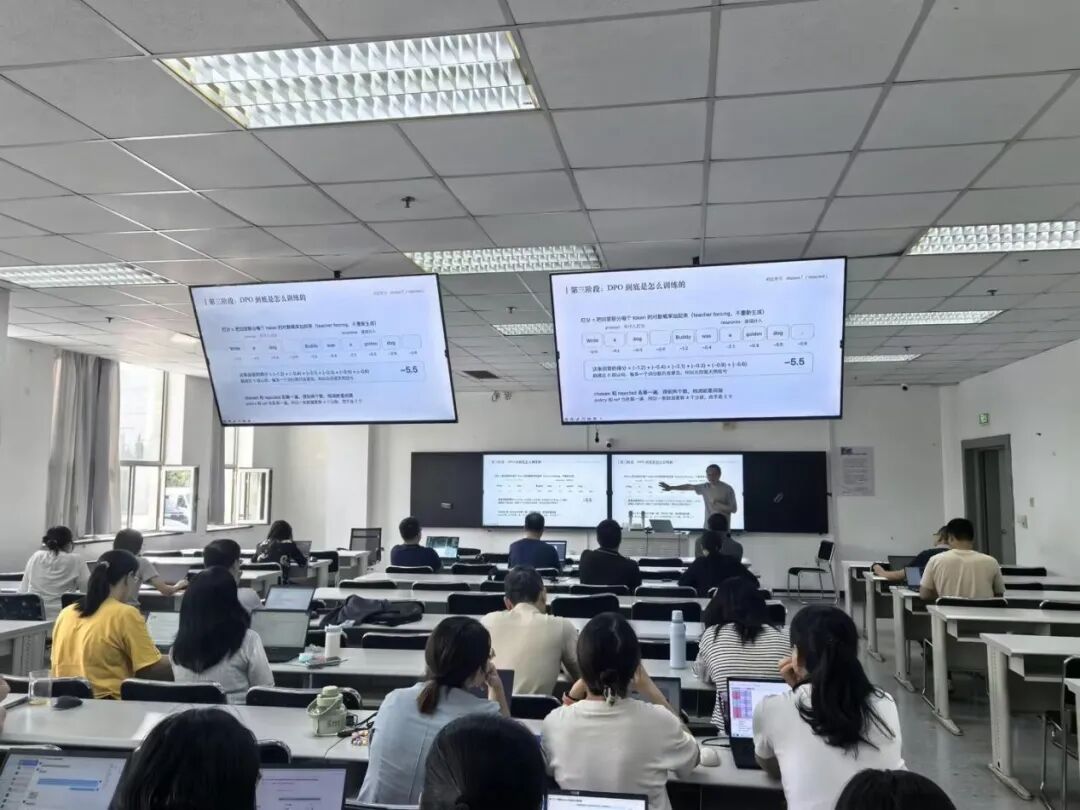
“数据决定行为,格式决定模型能学会什么。”培训的第一模块,讲师韩立带领老师们用30M参数的MiniGPT模型,完整跑通了工业界“预训练-监督微调(SFT)-偏好对齐(DPO)”的三阶段流程。
老师们亲自动手实践了如何用TinyStories数据让模型“学会说话”,如何通过Masking机制让模型“听懂指令”,以及利用DPO算法让模型分辨“好回答与差回答”。参训老师感慨:“以前讲课只能泛泛而谈大模型怎么训练,现在亲手跑过一次,才发现Loss曲线的每一次波动背后,都是数据与算法的博弈。这为我们讲好底层原理提供了底气。”
二、降维解析:重塑教学中的抽象概念
如何向学生通俗地讲透Transformer?培训中,韩立老师提供了令人耳目一新的教学法。对于高维枯燥的《注意力机制》,用“图书馆检索”来做类比——Query是“想找什么”,Key是“书本的标签”,Value是“书里的内容”,瞬间让深奥的数学公式变得鲜活。
从“训练为何要并行”到“掩码的公平协议”,培训不仅传授了知识,更传递了教学技巧。老师们在交流中表示:“原来掩码不仅是防作弊,更是训练并行与推理串行的公平协议。把这些生动的类比带回课堂,学生的畏难情绪一定会大大降低。”
三、走向实战:从“能跑”跨越到“能扛”
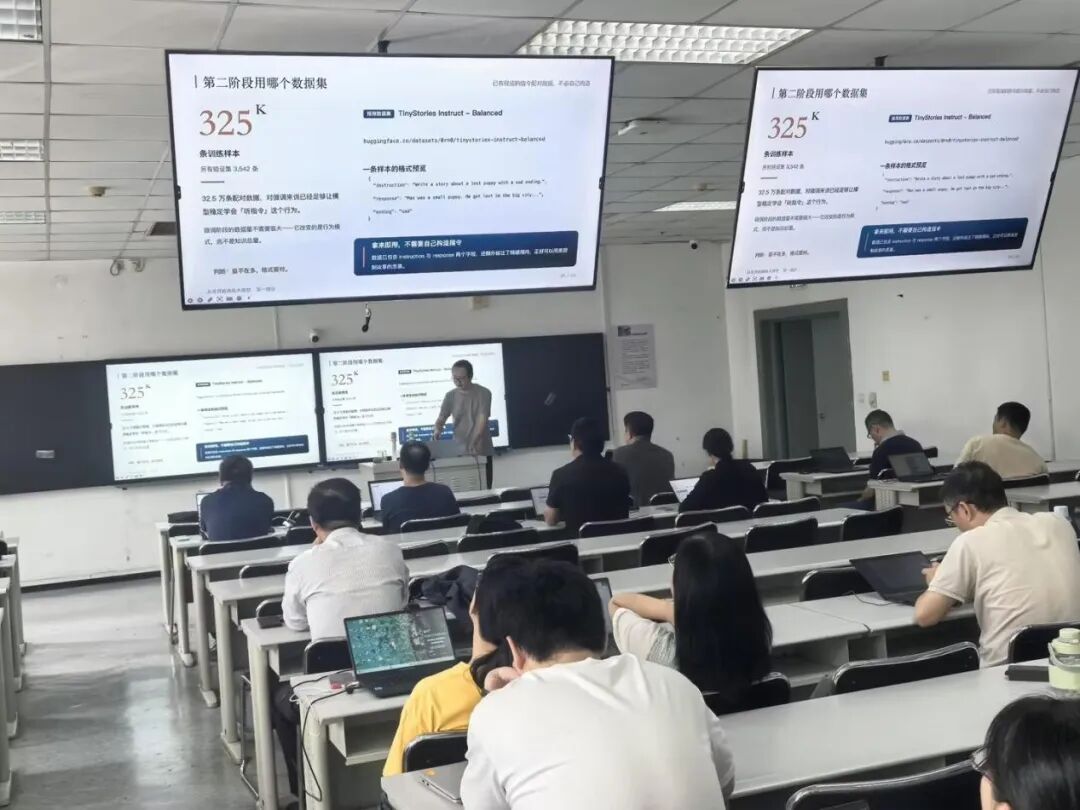
本次培训最“硬核”的部分,在于解决大模型落地时“回复慢”与“一并发就崩”的痛点。培训直击工程落地前沿,带领老师们深入部署优化(serve/)环节。
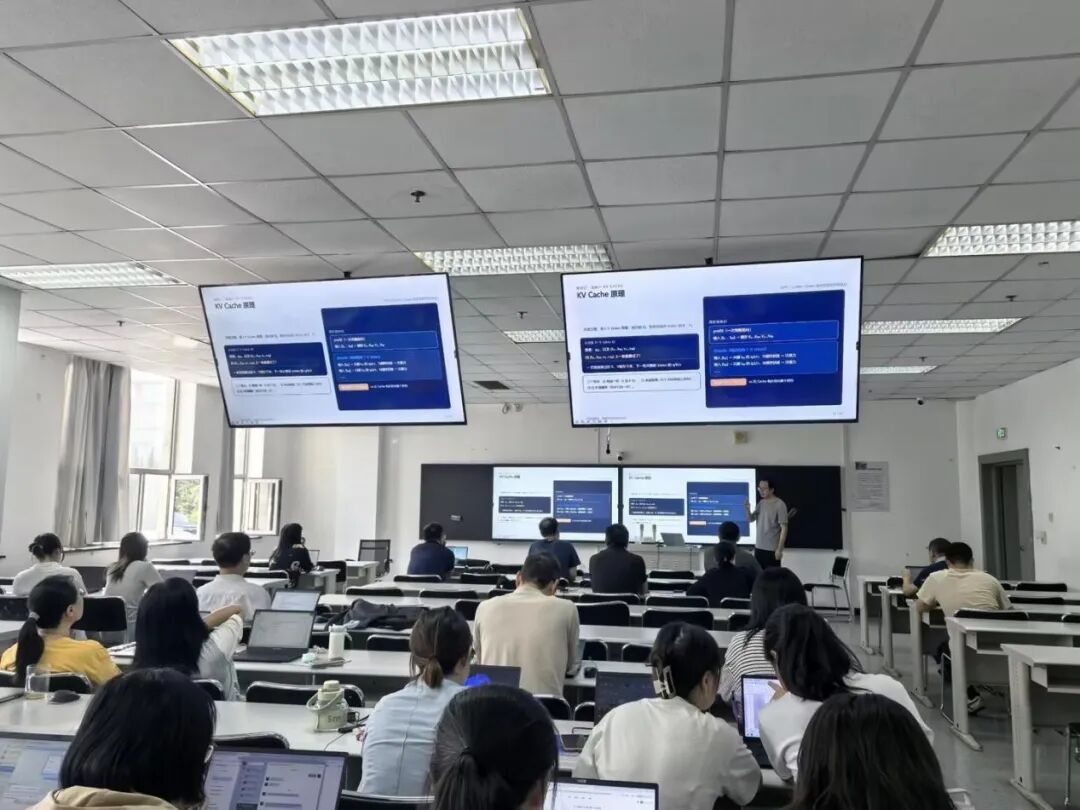
老师们进行了令人大呼过瘾的压测实验。为了解决生成太慢的问题,大家亲手实现了KV Cache技术,将重复计算从O(N²)降到O(N),并通过“同种子同输出”的等价性验证,落实了“先证明正确,再证明变快”的工程伦理。
针对高并发下系统雪崩的噩梦,培训引入了服务治理模块。老师们学习并实践了如何利用信号量实现429快速失败机制,结合利特尔法则科学推导容量阈值,并用多进程--workers榨干CPU算力。同时,通过部署/metrics可观测性指标,学会用QPS和P95延迟等数据理性评估系统性能。
四、结语:师资赋能,照亮更广阔的课堂
“结论靠实测,不靠背。”这是本次培训贯穿始终的原则。此次师资培训,不仅是一次技术的进阶,更是一次教学理念的升级。
通过为期数天的实战演练,老师们不仅掌握了驾驭大模型硬核工程的方法论,更积累了极其宝贵的实操案例与压测数据。这些来自真实环境的“一手经验”,将直接转化为生动的课堂教学内容。我们相信,这支懂底层、能实战的教师队伍,必将反哺给学生更加优质、前沿的AI课程,为培养新时代复合型技术人才奠定坚实的基础。
- 上一篇:没有了
- 下一篇:科研讲座 | 第十二期 共享智慧,协同创新,构筑科研交流平台